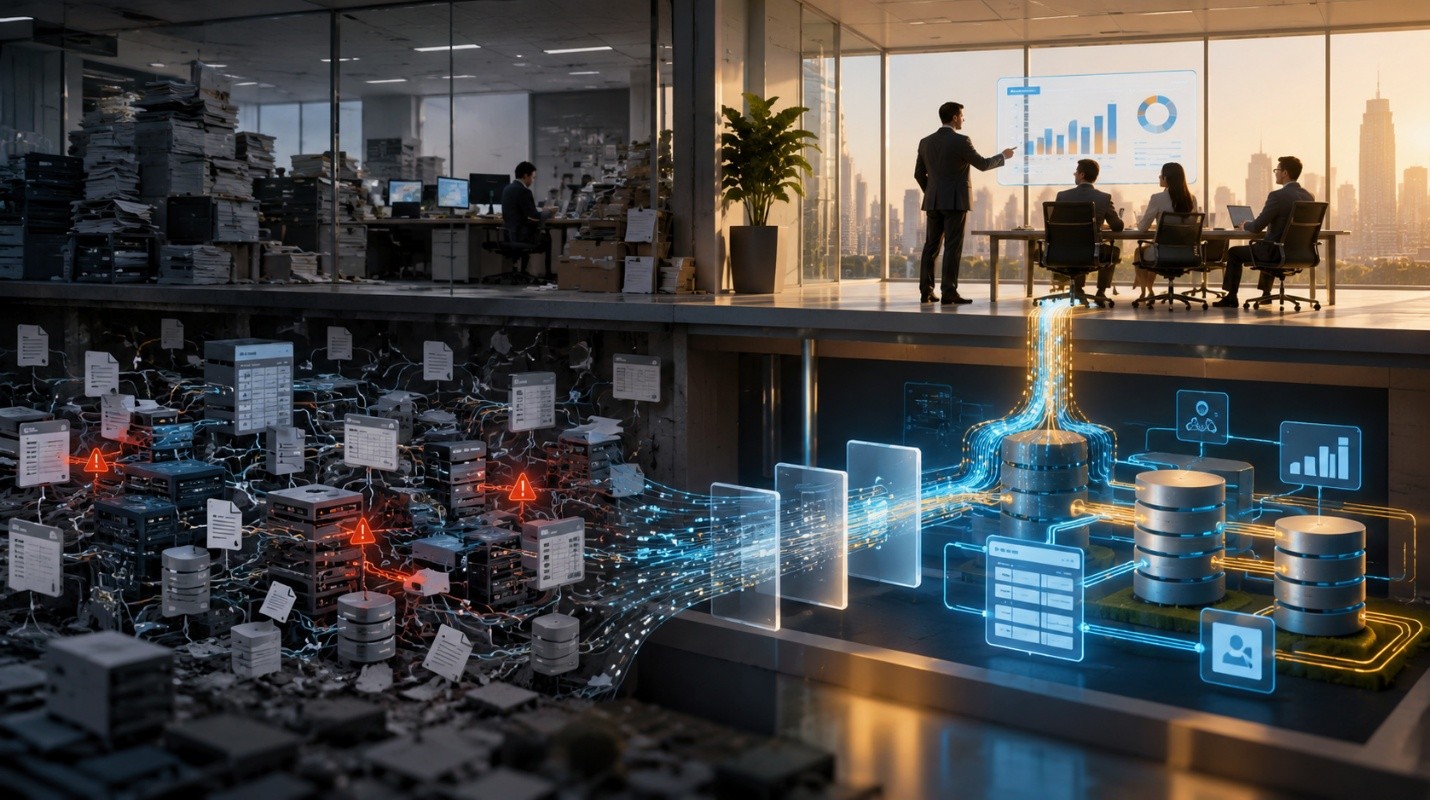
گاهی گرانترین اشتباه یک سازمان، اشتباهی است که هیچکس متوجه وقوعش نمیشود.
ماهها بود که نامش از فهرست کارکنان حذف شده بود. کارت ورودش غیرفعال شده بود، تجهیزاتش را تحویل داده بود و احتمالاً دیگر کسی در سازمان سراغش را نمیگرفت.
اما یکجا هنوز حضور داشت: فهرست حقوق و دستمزد.
هر ماه، درست مثل زمانی که کارمند شرکت بود، نامش در میان دریافتکنندگان حقوق قرار میگرفت. محاسبات انجام میشد، مبلغ نهایی تأیید میشد و پرداختها ادامه پیدا میکردند.
هیچ هشدار قرمزی روی صفحه ظاهر نشده بود. هیچ گزارشی از وقوع یک اتفاق غیرعادی خبر نمیداد. از نظر سیستم، همهچیز درست پیش میرفت.
تا روزی که دو فهرست کنار هم قرار گرفتند.
یکی میگفت این فرد مدتهاست از سازمان رفته. دیگری نشان میداد که هنوز حقوق میگیرد.
اشتباه پیدا شده بود؛ اما کشف آن، بهجای اینکه خیال مدیران را راحت کند، سؤال تازهای به وجود آورد:
چند نفر دیگر ممکن است فقط روی کاغذ، هنوز کارمند این سازمان باشند؟
و بعد، سؤالی بزرگتر: اگر سازمان نمیتواند با اطمینان بگوید چه کسانی در فهرست پرداختهایش قرار دارند، درباره کدام بخشهای دیگر کسبوکارش نیز چنین تصویری دارد؟
شاید مشکل در نگاه اول، خطای واحد حقوق و دستمزد به نظر برسد. اما پرداخت، آخرین حلقه زنجیرهای است که خیلی زودتر آغاز شده: روزی که فرد از سازمان خارج شده، اما این تغییر در تمام اطلاعاتی که باید، منعکس نشده است.
سازمان خروج او را میدانست. سیستم پرداخت، نه.
و میان این دو، پول واقعی جابهجا میشد.
داده؛ میان جلوگیری از زیان و خلق ارزش
در چنین موقعیتی، نخستین اقدام سازمان روشن است: پرداخت اشتباه متوقف میشود و سوابق اصلاح میشوند. اما برای مدیران ارشد، ماجرا به همینجا ختم نمیشود. مسئله بزرگتر این است که سازمان تا چه اندازه میتواند به اطلاعاتی که مبنای فعالیتها و تصمیمهایش قرار میگیرند، اعتماد کند.
(DalleMule & Davenport, 2017) در مقاله "What's Your Data Strategy?" در نشریه Harvard Business Review، دو جهتگیری مکمل را برای مدیریت داده معرفی میکنند: رویکرد دفاعی (Defensive) و رویکرد توسعهای (Offensive).
رویکرد دفاعی بر حفاظت از اطلاعات، کاهش ریسک، تضمین کیفیت و ایجاد منابع معتبر داده تمرکز دارد. در مقابل، رویکرد توسعهای به استفاده از اطلاعات برای بهبود عملکرد، شناخت فرصتهای جدید و خلق ارزش اقتصادی میپردازد.
نکته مهم پژوهش آنها این است که این دو رویکرد، با وجود مکملبودن، الزامات متفاوتی دارند. در فعالیتهای حساس مالی و قانونی، کنترل و یکپارچگی اهمیت بیشتری پیدا میکند؛ در حالی که تحلیل و نوآوری به امکان دسترسی، ترکیب و استفاده انعطافپذیر از اطلاعات وابستهاند. بنابراین، سازمان به استراتژیای نیاز دارد که میان حفاظت از داده و بهرهبرداری از آن تعادل برقرار کند.
در بسیاری از سازمانهای ایرانی، سهم این دو رویکرد بهطور طبیعی برابر نیست. بخشی از سازمانها تمام بودجه و توجه خود را صرف محدودسازی میکنند: دسترسیها بسته میشود، خروجیها قفل میشوند و در نهایت چیزی باقی نمیماند که ارزش محافظت از آن معنا داشته باشد. در مقابل، بعضی سازمانها از روز اول سراغ داشبورد و تحلیل و هوش مصنوعی میروند، در حالی که زیر این لایه نمایشی، دادههایی نشستهاند که معلوم نیست چه کسی تولیدشان کرده، کدام نسخه درست است و با کدام تعریف بهروز شدهاند. هر دو حالت، دو روی یک سکهاند: سازمانی که فقط محافظت میکند، از داده چیزی نمیسازد و سازمانی که فقط تحلیل میکند، روی پایهای لرزان بنا میگذارد. تعادل میان این دو همان چیزی است که تفاوت یک استراتژی داده با مجموعهای از خریدهای پراکنده نرمافزاری را نشان میدهد.
در ماجرای حقوق و دستمزد، جلوگیری از پرداخت اشتباه، نمونهای از ارزش دفاعی داده است. اما همان اطلاعات استخدامی و مالی، در صورت اعتبار و قابلیت استفاده، میتوانند مبنای تحلیل هزینه نیروی انسانی، برنامهریزی ظرفیت و تصمیمگیری درباره تخصیص منابع نیز باشند.
اهمیت داده فراتر از ثبت اطلاعات است؛ دادههای معتبر نهتنها از هدررفت منابع جلوگیری میکنند، بلکه فرصتهای تازهای برای بهبود عملکرد ایجاد میکنند؛ فرصتهایی که ضعف کیفیت داده میتواند از سازمان بگیرد.
وقتی اصلاح خطا، خود به یک هزینه تبدیل میشود
برای جلوگیری از تکرار ماجرای آغازین، مدیرعامل احتمالاً دستور میدهد فهرست کارکنان و پرداختها پیش از هر دوره حقوق و دستمزد تطبیق داده شوند. شاید تأییدهای بیشتری نیز به فرایند اضافه شود.
این اقدامات میتوانند از پرداخت اشتباه جلوگیری کنند، اما یک مسئله را حل نمیکنند: اگر اطلاعات همچنان در مبدأ نادرست ثبت یا بهروزرسانی شوند، سازمان باید هر ماه برای شناسایی و اصلاح آنها هزینه بپردازد.
(Redman, 2020) این فعالیتهای جبرانی را «کارخانه پنهان داده» (Hidden Data Factory) مینامد؛ بخشی نامرئی از عملیات که زمان کارکنان را صرف تطبیق، پاکسازی و اصلاح اطلاعات میکند.
نکته کلیدی ردمن این است که کنترل بیشتر در انتهای فرایند، لزوماً به معنای کیفیت بیشتر داده نیست. اگر خطا همچنان در مبدأ تولید شود، سازمان فقط در شناسایی و جبران پیامدهای آن ماهرتر شده است.
تصویر این کارخانه در ادارات و شرکتهای ما کاملاً آشناست. فایلی با نامی شبیه نسخه نهایی تأییدشده دو که بین واحدها دستبهدست میشود، کارشناسی که دو روز از هفتهاش صرف همرقمکردن دو گزارش میشود، جلسهای که تنها برای کشف منشأ اختلاف سیصد میلیونی دو صورتمالیه تشکیل میشود و نشستهایی که پیش از هر جلسه مهم به جلسه آمادهسازی جلسه تبدیل شدهاند، همه از ساختمانهای پنهان همین کارخانهاند. نکته تلخ ماجرا این است که هیچکدام از این فعالیتها در هیچ نمودار سازمانی ثبت نشدهاند؛ نه بودجهای برایشان تخصیص یافته و نه در پایان سال از آنها گزارش عملکردی ارائه میشود. سازمانی که این هزینه را اندازه نگرفته، اغلب تصور میکند مشکلش نبود سرمایهای برای خرید سیستم جدیدتر است؛ در حالی که بخش قابل توجهی از آن سرمایه، همین حالا هم در جابهجایی و اصلاح دستی دادهها دارد سوخت میشود.
ابعاد این مسئله را پژوهش (Nagle et al., 2020) روشنتر میکند. آنها در بررسی ۷۵ ارزیابی کیفیت داده گزارش کردند که در نمونه مورد مطالعه، بهطور میانگین ۴۷ درصد رکوردهای تازهتولیدشده دستکم یک خطای بحرانی داشتهاند. این یافته قابلتعمیم مستقیم به همه سازمانها نیست، اما نشان میدهد نظم ظاهری سیستمها، تضمینی برای اعتبار اطلاعات نیست.
هر ارزیابی هم که برای تکرار این آزمون لازم باشد، خودش کار و هزینه دارد؛ یعنی همان جایی که سازمان دنبال کاهش هزینه است، باید برای پیدا کردن هزینههای پنهانش پول خرج کند. به همین دلیل است که پاسخ واقعی، ارزیابیهای پرتعداد نیست؛ اصلاح مبدأ خطاست، همانجا که رکورد ساخته میشود، نه پایین دستِ آن.
نبود داده ضروری نیز میتواند بهاندازه داده نادرست مسئلهساز باشد. وقتی سازمان اطلاعات لازم برای شناخت هزینه، عملکرد یا تغییرات فعالیتهای خود را ثبت نکرده باشد، تصمیمگیری به برآورد، فرض یا قضاوتهای غیرقابلآزمون وابسته میشود.
این جور جاها معمولا کسی مقصر نیست؛ کسی که میخواهد تصمیم بگیرد صادقانه میگوید «طبق تجربهام میدانم» و واقعا هم میداند. مشکل آنجاست که تجربه، بدون داده، قابل انتقال و آزمون نیست و با رفتن یک فرد، از سازمان میرود.
در مقابل، اطلاعات معتبر ظرفیت اقتصادی متفاوتی دارند.
(Jones & Tonetti, 2020) در مقاله Nonrivalry and the Economics of Data، یکی از ویژگیهای مهم داده را «غیررقابتیبودن در مصرف» (Nonrivalry) معرفی میکنند. برخلاف بسیاری از منابع فیزیکی، استفاده از داده برای یک هدف، لزوماً امکان استفاده مجدد از آن را از بین نمیبرد.
اطلاعات معتبر فروش میتوانند همزمان در ارزیابی عملکرد شعب، پیشبینی تقاضا، مدیریت موجودی و برنامهریزی بازاریابی استفاده شوند. بنابراین، یکبار سرمایهگذاری در تولید اطلاعات قابلاتکا ممکن است از تصمیمهای متعددی پشتیبانی کند.
همین منطق در مقیاس یک کسبوکار کوچکتر هم صادق است. مغازهدار ایرانی قدیم با دفتری که بدهی مشتریهای ثابتش را در آن مینوشت، در واقع همان کار را میکرد: یک ثبت ساده که چند بار در روز به تصمیمهای مختلف خدمت میکرد، از اعتبارسنجی مشتری تا تصمیم درباره خرید کالا. سازمان امروز دقیقا همین کار را انجام میدهد، فقط با ابزارهایی پیچیدهتر و با یک تفاوت سرنوشتساز: آن دفتر قدیمی را خود صاحبش هر شب مرور و اصلاح میکرد، اما رکوردهای سیستمهای امروزی را معمولا کسی مرور نمیکند و خطایشان تا روز رسیدگی باقی میماند. دارایی بودن داده، پیش از هر چیز به همین مرور و رسیدگی مستمر وابسته است.
البته این ظرفیت به معنای ارزشمندبودن خودکار هر دادهای نیست. اطلاعاتی که نادرست، نامفهوم، نامرتبط یا غیرقابلدسترسی باشند، ممکن است بیش از آنکه ارزش ایجاد کنند، هزینه تحمیل کنند.
پس پرسش بعدی روشن است: چه ویژگیهایی باعث میشوند داده واقعاً قابلاعتماد و قابلاستفاده باشد؟
چه دادهای واقعاً خوب است؟
در نگاه نخست، پاسخ روشن به نظر میرسد: داده باید صحیح، کامل و بهروز باشد. اما آیا اطلاعات کاملاً صحیح، همیشه برای تصمیمگیری کافیاند؟
پژوهش (Wang & Strong, 1996) در مقاله "Beyond Accuracy" نشان میدهد کیفیت داده از نگاه استفادهکنندگان، فراتر از صحت مقادیر است. تناسب با هدف، قابلیت فهم، دسترسی و اعتبار منبع نیز در کیفیت نقش دارند.
این یافته به یک اصل مهم میرسد: داده خوب صرفاً داده بدون خطا نیست؛ دادهای است که برای کاربرد موردنظر مناسب باشد.
پژوهشگران چارچوبی برای سنجش چنین کیفیتی ارائه کردهاند که شش ویژگی اصلی را کنار هم میگذارد و برای هر یک، معیار عملی اندازهگیری پیشنهاد میدهد. این چارچوب که نخستینبار دولت بریتانیا برای مدیریت کیفیت دادههای خود تدوین کرد، میتواند برای سازمانهای ایرانی هم نقطه شروع خوبی باشد.
ویژگی نخست دقت است؛ اینکه اطلاعات با واقعیت مطابقت دارند و میتوان میزان آن را با درصد رکوردهایی که با منبع معتبر تأیید شدهاند سنجید. دوم، کاملبودن است؛ یعنی اطلاعات ضروری برای کاربرد موردنظر موجود باشند و معیارش معمولا درصد تکمیل فیلدهای الزامی است. سوم، بهموقعبودن است؛ اینکه اطلاعات هنگام نیاز معتبر و در دسترس باشند، چیزی که با فاصله زمانی میان وقوع رویداد و ثبت معتبر آن اندازهگیری میشود. چهارم، سازگاری است؛ اینکه اطلاعات مرتبط در منابع مختلف، تناقض حلنشده نداشته باشند و تعداد مغایرتهای میان سیستمها نشانگر آن است. پنجم، یکتایی است؛ یعنی یک موجودیت بدون ضرورت تکرار نشده باشد و نرخ رکوردهای تکراری آن را نشان میدهد. و ششم، اعتبار است؛ اینکه مقادیر با قواعد تعیینشده سازگار باشند و درصد رکوردهای منطبق با قواعد، معیار سنجش آن است.
این ویژگیها مکمل یکدیگرند، اما اهمیت آنها برای همه تصمیمها یکسان نیست.
برای مثال، در تصمیمی فوری ممکن است اطلاعات بهموقع اما هنوز نهایینشده، از گزارش کاملی که پس از پایان فرصت تصمیمگیری آماده میشود مفیدتر باشند؛ به شرط آنکه محدودیت اطلاعات برای تصمیمگیرنده روشن باشد.
چارچوب دولت بریتانیا نیز به تعامل میان ابعاد کیفیت توجه میکند. بنابراین، هدف نباید دستیابی به دادهای بینقص به هر قیمت باشد؛ بلکه باید سطح کیفیت موردنیاز را بر اساس کاربرد، ریسک و هزینه تعیین کرد.
در عمل، بیشترین دعواهای دادهای سازمانها نه بر سر دقت، که بر سر تعریف رخ میدهد. وقتی واحد فروش از مشتری فعال تعریفی میسازد، مالی تعریفی دیگر دارد و بازاریابی هم نسخه سوم را به کار میبرد، هر سه گزارش درستاند و با این حال هیچکدام به درد تصمیم مشترک نمیخورند. پیش از هر سرمایهگذاری فناورانه، لازم است سازمان برای مفاهیم پرتکرار خود یعنی مشتری، سفارش، فروش، کالای مرجوع و دهها مفهوم دیگری که هر روز دربارهشان حرف میزند، یک تعریف رسمی و مکتوب داشته باشد. این کار در ظاهر حوصلهمند است، اما همان زبان مشترکی را میسازد که بدون آن، یکپارچهسازی سیستمها فقط اتصال دو شبکه با ولتاژ متفاوت است. چارچوب ششگانه کیفیت هم زمانی معنا پیدا میکند که برای هر یک از ابعاد، عدد و سطح قابل قبولی تعریف شود؛ در غیر این صورت، کیفیت داده به شعاری تبدیل میشود که همه قبولش دارند و هیچکس نمیداند کی محقق شده است.
تجربه هر سازمان ایرانی هم همین را میگوید؛ در جلسهای که تصمیم فوری گرفته میشود، هیچکس سراغ گزارشی نمیرود که سه هفته بعد حاضر میشود، هرچند بینقص باشد. اصرار بر بینقسی مطلق، همانطور که اهمال در کیفیت خطرناک است، خودش هم میتواند شکل دیگری از هدر دادن منابع باشد. سطح مطلوب کیفیت، از تصمیم به تصمیم دیگر تغییر میکند و همین تغییر، کاری است کارشناسی، نه شعاری.
نکته دیگر آن است که داده ممکن است در مبدأ صحیح باشد، اما هنگام انتقال، تبدیل یا تجمیع دچار خطا شود. به همین دلیل، کنترل کیفیت باید مسیر اطلاعات از ثبت اولیه تا گزارش نهایی را در بر بگیرد. قابلیت ردیابی منشأ داده به سازمان کمک میکند این مسیر و تغییرات انجامشده را شناسایی کند.
پس کیفیت داده نه اتفاقی، بلکه نتیجه طراحی و کنترل فرایند تولید و استفاده از اطلاعات است.
این نتیجه پرسش بعدی را پیش میکشد: چگونه میتوان از ابتدا اطلاعاتی تولید کرد که چنین ویژگیهایی داشته باشند؟
داده ارزشمند چگونه ساخته میشود؟
وقتی کیفیت داده به کاربرد آن وابسته است، ساخت داده ارزشمند باید پیش از انتخاب نرمافزار آغاز شود؛ از زمانی که سازمان تصمیم میگیرد چه اطلاعاتی را ثبت کند، چگونه نگه دارد و در اختیار چه کسانی قرار دهد.
دانشگاه روچستر در راهنمای "Data Questions to Consider"، مجموعهای از ۲۳ پرسش را درباره ساختار ثبت اطلاعات، کیفیت، منابع معتبر، یکپارچگی سیستمها و نحوه استفاده از داده مطرح میکند. پیام اصلی این راهنما آن است که عملکرد صحیح یک سیستم، لزوماً به معنای تولید اطلاعات مناسب برای تحلیل و تصمیمگیری نیست.
با تکیه بر این پرسشها و پژوهشهای مدیریت داده، میتوان پنج اقدام کلیدی را پیشنهاد کرد.
اقدام نخست از تصمیم شروع میکند، نه از داده. ابتدا باید مشخص شود سازمان برای کدام تصمیمها به اطلاعات نیاز دارد و این اطلاعات باید با چه جزئیات و تناوبی در دسترس باشند؛ سپس دادههای موجود و کمبودهای اطلاعاتی شناسایی شوند. هدف، جمعآوری بیشترین داده نیست؛ تولید اطلاعاتی است که کاربرد مشخصی در تصمیمگیری دارند. تجربه بسیاری از سازمانها نشان میدهد برعکسِ این ترتیب کار میکند: اول ابزار و گزارش میخرند، بعد دنبال کاری میگردند که با آنها انجام شود. نتیجه، انباری از اطلاعات بیمصرف و فهرستی از گزارشهایی است که هیچکس نمیخواند؛ هفتهای یک ساعت هم که صرف تهیه هر گزارش شود، در مقیاس سال و سراسر سازمان، هزینهای جدی میشود که هیچ سرفصلی برای آن باز نشده است.
اقدام دوم، ساختار و تاریخچه اطلاعات را آگاهانه طراحی میکند. راهنمای روچستر میپرسد هر رکورد نماینده چیست؛ یک فرد، قرارداد یا تراکنش؟ همچنین بر شناسههای یکتا، مدیریت مقادیر گمشده، مدت نگهداری و انتقال اطلاعات تاریخی تأکید دارد.
این تصمیمها تعیین میکنند سازمان در آینده چه تحلیلهایی میتواند انجام دهد. برای مثال، سیستمی که فقط وضعیت فعلی کارکنان را ذخیره میکند، امکان بررسی روند جابهجایی آنها در سالهای گذشته را فراهم نمیکند.
اقدام سوم، مرجع معتبر و مسئولیت داده را مشخص میکند. وقتی اطلاعات در چند سیستم ثبت میشوند، باید معلوم باشد کدام منبع معتبر است، تعاریف اطلاعات چیست و مسئول صحت و بهروزرسانی آنها چه کسی است.
این موضوع در پرسشهای روچستر درباره منابع معتبر، مستندسازی تعاریف و هماهنگسازی اطلاعات مطرح شده است. اتصال سیستمها بهتنهایی یکپارچگی ایجاد نمیکند؛ اطلاعات باید با تعاریف و قواعد مشترک مبادله شوند.
اقدام چهارم، کیفیت را در مبدأ ایجاد میکند. راهنمای روچستر بر شناسایی دادههای تکراری، اعتبارسنجی، رسیدگی به خطاها و کنترل تغییرات تأکید دارد.
این کنترلها باید تا حد امکان هنگام ثبت و بهروزرسانی اطلاعات اجرا شوند، نه صرفاً هنگام تهیه گزارش. همانطور که (Redman, 2020) توضیح میدهد، کاهش خطا در مبدأ، مؤثرتر از اتکای مداوم به اصلاح اطلاعات نادرست است.
و اقدام پنجم، دادهها را برای دسترسی و استفاده مجدد آماده میکند. یکی از پرسشهای راهنمای روچستر این است که کاربران نهایی چگونه میتوانند از اطلاعات استفاده کنند؛ آیا به گزارشهای آماده نیاز دارند یا امکان تحلیل مستقیم دادهها را دارند؟ مستندسازی اطلاعات (Metadata) و مدیریت دسترسی نیز در همین زمینه اهمیت پیدا میکنند.
اما دسترسی، تنها بخشی از ماجراست. (Wixom & Piccoli, 2021) در پژوهش MIT CISR مفهوم "نقدشوندگی داده" (Data Liquidity) را مطرح میکنند؛ یعنی سهولت آمادهسازی، ترکیب و استفاده مجدد از اطلاعات. تفاوت مهم اینجاست که استفاده از داده برای حل یک مسئله مشخص، لزوماً به معنای ساخت یک دارایی اطلاعاتی نیست. دارایی واقعی زمانی شکل میگیرد که سازمان بتواند برای پاسخ به پرسشهای جدید نیز از اطلاعات موجود استفاده کند، بدون آنکه هر بار فرایند جمعآوری و آمادهسازی را از ابتدا تکرار کند.
این تصویر برای مدیر ایرانی ممکن است کمی دور از دسترس به نظر برسد، اما مثالی ساده آن را به آشپزخانه سازمان میآورد. داده بدون نقدشوندگی مثل انبار موادی است که برای هر غذا باید از صفر بخرید؛ هر سفارش، یک سفر جدید، یک هزینه جدید و یک اتلاف جدید. داده نقدشونده اما مثل آشپزخانهای منظم است که مواد آن آماده، برچسبخورده و قابل ترکیباند؛ همان مواد اولیه، دهها غذای مختلف. تفاوت این دو آشپزخانه را سر آشپز هم بلد است توضیح دهد؛ یعنی مسئله، فناوری نیست، نظم است.
با این حال، آمادهبودن اطلاعات به معنای استفاده واقعی از آنها نیست؛ کارکنان و مدیران باید به تعاریف مشترک اعتماد کنند و داده را مبنای تصمیمهای خود قرار دهند. افزون بر این، پژوهش (MIT CISR، ۲۰۲۵) تأکید میکند که داراییهای داده باید مانند محصولات مدیریت شوند؛ با استفادهکنندگان مشخص، مسئول نگهداری، معیارهای کیفیت و سنجش میزان استفاده. حتی کنار گذاشتن داراییهایی که دیگر ارزشی ایجاد نمیکنند، بخشی از این مدیریت است.
بنابراین، داده با یکبار تولیدشدن به دارایی پایدار تبدیل نمیشود؛ ارزش آن به قابلیت استفاده مجدد، پذیرش سازمانی و مدیریت مستمر در طول عمرش وابسته است.
اما ساخت چنین زیرساختی به این معنا نیست که سازمان باید تمام دادههای خود را همزمان بازطراحی کند. پرسش بعدی این است که سرمایهگذاری در کیفیت و مدیریت داده باید از کجا آغاز شود؟
از کجا باید شروع کرد؟
پاسخ، لزوماً اجرای یک پروژه بزرگ و فراگیر نیست. منطقیتر است سازمان از دادههایی آغاز کند که ضعف آنها بیشترین اثر را بر تصمیمها و عملکرد دارد.
برای اولویتبندی، سه پرسش کافی است. نخست اهمیت: خطا یا نبود این اطلاعات چه اثری بر هزینه، درآمد، ریسک یا کیفیت تصمیم دارد؟ دوم وضعیت موجود: اطلاعات موردنیاز تا چه اندازه وجود دارند و کیفیت آنها چگونه است؟ و سوم امکان اصلاح: آیا میتوان با تغییر فرایند ثبت، تعیین مسئولیت یا ایجاد کنترلهای مشخص، وضعیت را بهبود داد؟
راهنمای کیفیت داده دولت بریتانیا نیز بر شناسایی دادههای حیاتی و متناسبکردن اقدامات کنترلی با ریسک و اهمیت کاربرد تأکید دارد.
پس سازمان میتواند یک حوزه مهم را انتخاب کند، وضعیت فعلی کیفیت را اندازه بگیرد، اصلاحات را در مبدأ اجرا کند و نتیجه را بسنجد. تجربه حاصل، مبنای توسعه تدریجی مدیریت داده در سایر بخشها خواهد بود.
این نقطه شروع در بسیاری از سازمانهای ایرانی معمولا مشخص است؛ جایی که اختلاف رقمها بارها بحث شده و هر واحد، نسخه خودش از «عدد واقعی» را دارد. فروش میگوید فروش رفته، مالی میگوید وصول شده و انبار میگوید خارج شده؛ و هیچکدام اشتباه نمیکنند، اما هیچکدام هم حرف دیگری را نمیفهمند. همین یک عدد، اگر یکبار برای همه یکسان شود، ارزش پروژههای بزرگ داده را پیش از هر ارائهای نشان میدهد.
یک نکته مدیریتی هم درباره فضای این اقدامات وجود دارد. هر جا کشف خطای داده به جستوجوی مقصر تبدیل شود، پاسخ طبیعی کارکنان پنهانکردن خطاست؛ گزارشها تمیزتر از واقعیت میشوند، مغایرتها به جلسه بعدی موکول میشوند و مدیریت ارشد هر روز کمی از میدان دورتر میشود. سازمانی که داده را دارایی میداند، اعلام خطای داده را بهاندازه کشف یک فرصت کسبوکار تشویق میکند؛ کارمندی که رکورد اشتباه را گزارش میکند، در واقع هزینهای را که چند ماه بعد سر بر میآورد، امروز و با نرخ ارزان پرداخت کرده است. این نگاه باید در عمل هم دیده شود؛ واکنش اول به خطای کشفشده اصلاح مبدأ است، نه مؤاخذه گزارشدهنده. پیام کتاب «داده مال همه است» نیز همین است: مدیریت داده پروژهای انحصاری در واحد فناوری اطلاعات نیست؛ کاری است که در هر ثبت، هر فرم و هر تأییدی در سراسر سازمان یا انجام میشود یا رها میشود.
اما موفقیت این اقدامات فقط با کاهش خطا سنجیده نمیشود.
(Wixom et al., 2023) در کتاب "Data Is Everybody's Business" سه مسیر خلق ارزش از داده را معرفی میکنند: بهبود عملیات داخلی، ارتقای محصولات و خدمات با استفاده از داده، و ایجاد محصولات اطلاعاتی.
این تقسیمبندی کمک میکند هر سرمایهگذاری در داده به یک هدف اقتصادی مشخص متصل شود. برای کاهش مغایرتهای مالی، نرخ خطا و هزینه رسیدگی میتوانند معیار باشند؛ برای بهبود تخصیص منابع، باید اثر تصمیمهای جدید بر هزینه یا عملکرد بررسی شود.
ارزش داده زمانی محقق میشود که اطلاعات به شناخت بهتر، تصمیم متفاوت و نتیجه قابلاندازهگیری منجر شوند.
داراییای که باید آگاهانه ساخته شود
در ماجرای آغازین، اصلاح پرداخت اشتباه میتوانست زیان جاری را متوقف کند؛ اما جلوگیری از تکرار آن به اصلاح فرایند تولید و تبادل اطلاعات نیاز داشت.
این تفاوت میان داشتن داده و مدیریت آن بهعنوان دارایی است.
داده زمانی ارزش اقتصادی پایدار پیدا میکند که سازمان بداند چه اطلاعاتی نیاز دارد، چگونه باید آنها را تولید کند، چه کیفیتی از آنها انتظار دارد و چگونه میتواند بارها از آنها برای تصمیمهای بهتر استفاده کند.
نشانه این تحول را نمیتوان در اسناد استراتژی جستوجو کرد؛ در رفتار روزمره جلسهها دیده میشود. سازمانی که داده برایش دارایی شده، جلسهاش با پرسشهایی متفاوت اداره میشود: این عدد از کدام منبع آمده، آخرین بار کی بهروز شده و کسی مخالفتی با آن دارد یا نه. سؤالهایی که در نگاه اول کندکننده به نظر میرسند، اما در واقع همان کنترل کیفیاند که در مبدأ تصمیم اجرا میشوند. برعکس، سازمانی که داده برایش محصول جانبی است، همین اعداد را با اعتماد کامل جابهجا میکند و فقط پس از رسوا شدن در عمل میفهمد مبنا از اول سست بوده است. تفاوت این دو جلسه در سطح فناوری نیست؛ در فرهنگ پرسیدن است.
برای مدیرعامل، پرسش اصلی شاید این نباشد که سازمان چه مقدار داده دارد یا چند گزارش تولید میکند.
پرسش مهمتر این است:
«اگر فردا بخواهیم تصمیم مهمی بگیریم، کدام اطلاعات را میتوانیم بدون حدسزدن، بازسازی یا تطبیق دستی مبنای آن قرار دهیم؟»
پاسخ این پرسش نشان میدهد دادهها تا چه اندازه از محصول جانبی فعالیتهای روزمره، به یک دارایی واقعی سازمانی تبدیل شدهاند.
زیرا داده ارزشمند، محصول اتفاقی کارکردن سیستمها نیست؛ نتیجه تصمیمهای آگاهانه درباره نحوه تولید، مدیریت و استفاده از اطلاعات است.